Investigadores de la Universidad de California en San Diego entrenaron un agente de inteligencia artificial para estimar qué cree y qué desea su interlocutor, y usar esa información al decidir cómo actuar. El sistema se basa en Qwen2.5-7B-Instruct, un modelo de 7.000 millones de parámetros, y fue descrito en Mental-Models for Multi-Agent Systems.
El trabajo plantea una inferencia de estados mentales a partir de la interacción, no una lectura literal de pensamientos. Los autores identifican como responsables del estudio a Hanan Gani, Lulu Shao y Manmohan Chandraker.
Un agente que modela lo que piensa el otro
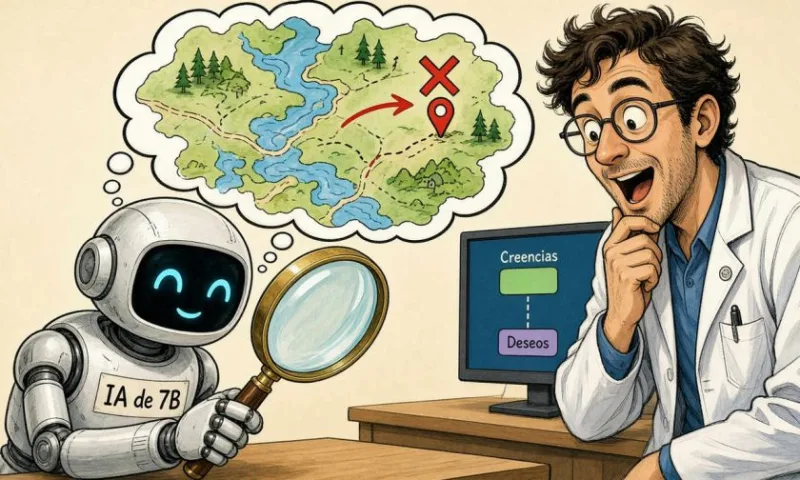
El enfoque se apoya en la teoría de la mente, una noción de la psicología que alude a la capacidad de reconocer que otras personas pueden tener creencias, metas y conocimientos distintos a los propios. En este caso, el sistema intenta construir una representación del estado mental oculto de su compañero de conversación.
El estudio distingue entre razonamiento de primer orden, que estima lo que el otro cree o desea, y razonamiento de segundo orden, que intenta anticipar lo que ese otro cree sobre el propio agente. Según el texto, esa segunda capa importa cuando cada participante debe prever cómo interpreta la situación el otro.
Los autores describen el método como un estado latente recursivo amortizado, es decir, una forma de reutilizar estimaciones internas sin reconstruir desde cero el razonamiento en cada turno. También agregaron un modelo de recompensa condicionado por creencias para entrenar la política del agente.
Las pruebas y las cifras reportadas
El equipo evaluó el sistema en Sotopia, BigToM y MMRole. Sotopia mide habilidades de interacción social, BigToM examina seguimiento de creencias y MMRole es una prueba multimodal.
En Sotopia, el modelo basado en Qwen2.5-7B obtuvo una mejora relativa promedio de aproximadamente 11,5% frente a la línea base. En BigToM, el equipo reportó una ganancia promedio de 26,7 puntos porcentuales en precisión pareada para creencias verdaderas y falsas.
Los autores también hicieron experimentos con variantes de 3.000 millones de parámetros y con familias como LLaMA y Mistral. Sin embargo, el material disponible no detalla resultados equivalentes para cada variante ni presenta una comparación completa de costos de ejecución.
El trabajo señala que la política final se destila para operar sin un modelo adicional durante la prueba. Esa es, según la descripción del estudio, la diferencia central entre el entrenamiento y el uso posterior del agente.
La publicación del código busca permitir que otros investigadores revisen y reproduzcan los experimentos. Aun así, las mejoras reportadas se limitan a los escenarios evaluados y no prueban una capacidad general para resolver cualquier problema de coordinación entre agentes.