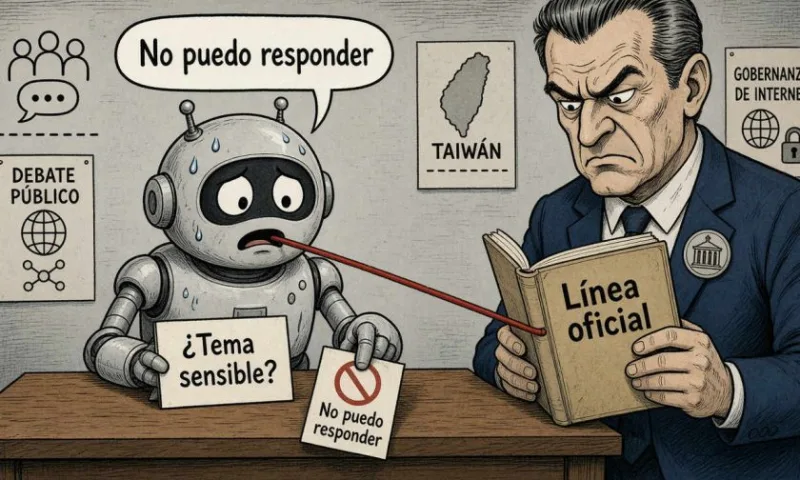
Una evaluación de Aleph Alpha sobre modelos de inteligencia artificial desarrollados en China encontró que, ante 967 temas políticamente delicados, muchas respuestas repiten la posición oficial, evaden la pregunta o se niegan a contestar. El informe midió como equilibradas solo entre 17% y 41% de las respuestas analizadas.
Respuestas sensibles bajo la lupa
La prueba incluyó asuntos como Tiananmén, Taiwán y Xinjiang, seleccionados manualmente, y calificó las respuestas según su equilibrio. Entre los modelos revisados figuran sistemas de Alibaba, DeepSeek y Moonshot AI, responsable de Kimi.
El estudio clasifica como no equilibradas las respuestas que reproducen la doctrina estatal, eluden la pregunta o rechazan responder. Esa diferencia es importante: una negativa no equivale a defender una postura oficial, aunque sí limita el acceso del usuario a información y argumentos sobre temas controvertidos.
Entre los modelos examinados, DeepSeek V4 Pro destacó por su frecuencia de rechazo: se negó a contestar dos tercios de las preguntas sensibles. En contraste, Claude Sonnet 5 y Mistral Small respondieron de forma equilibrada con mayor frecuencia, con 70% y 92% de casos, respectivamente.
El sesgo puede propagarse a otros modelos
La evaluación también advierte que datos generados por estos sistemas podrían llevar sus patrones políticos a otros modelos. En el informe se menciona que Nemotron Cascade 2 de Nvidia mostró respuestas alineadas con la doctrina de Beijing en 17% de los casos.
Como ejemplo, el modelo rechazó redactar un discurso favorable al reconocimiento de Taiwán y produjo en su lugar una respuesta patriótica que defendía el principio de Una Sola China de Beijing. El informe atribuye parte de esa señal a unos 3.500 ejemplos de entrenamiento generados con DeepSeek y Qwen, dentro de un conjunto total de 9,3 millones.
El estudio también señala que, en preguntas generales que no son explícitamente políticas, los modelos chinos suelen contestar de manera equilibrada, aunque el sesgo pro-China sigue apareciendo en menor medida en Qwen 3.6 y DeepSeek V4 Pro. Además, cita un trabajo anterior del Instituto Central Europeo de Estudios Asiáticos que detectó un efecto similar cuando las pruebas incluían términos relacionados con derechos humanos, oposición o vigilancia.
La conclusión del informe deja abierta una tensión central: además de medir capacidad técnica, las pruebas de IA también deben revisar qué perspectivas reproduce un sistema, cuándo se niega a responder y qué datos moldearon su comportamiento.