Una investigación liderada por especialistas de ByteDance advirtió que la tecnología de ahorro de memoria de DeepSeek podría hacer que sus modelos pasen por alto información según la posición que ocupa en un documento extenso. El hallazgo también apareció en DeepSeek-V4, V4.1 y otros modelos comprimidos preentrenados por los autores, aunque el trabajo todavía no ha sido revisado por pares.
La memoria más eficiente también puede afectar la respuesta
Según informó South China Morning Post, el trabajo planteó que reducir la memoria necesaria para procesar entradas largas podría afectar la fiabilidad con que los modelos identifican datos relevantes. El problema, de acuerdo con los autores, no sería necesariamente la ausencia de la información, sino su recuperación inconsistente según dónde aparezca.
Los investigadores observaron que la posibilidad de pasar por alto un dato variaba con la ubicación dentro del documento. Ese comportamiento cobra importancia cuando una consulta depende de elementos dispersos en un contexto extenso.
Un ejemplo con código mostró el efecto
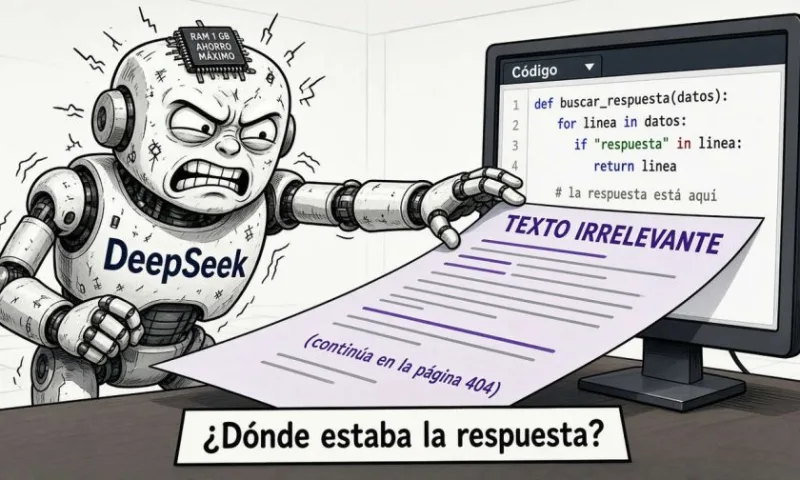
Para ilustrar el problema, el estudio describió una prueba con un fragmento de código informático. Añadir texto irrelevante antes de ese mismo fragmento redujo la capacidad de DeepSeek para escoger la respuesta correcta.
El hallazgo sugiere que cambios en la organización del contexto pueden alterar el resultado, aunque el contenido central de la tarea siga siendo el mismo. La publicación no cuantificó cuánto cayó el rendimiento ni con qué frecuencia se repitieron los errores.
El trabajo sigue sin revisión por pares
El artículo fue dirigido por investigadores de ByteDance y contó con coautores afiliados a la Universidad de Princeton, la Universidad de Stanford y la Universidad de California, Berkeley. South China Morning Post informó que el trabajo se publicó a finales de septiembre de 2026 y que todavía no había sido sometido a revisión por pares.
Esa condición no invalida por sí sola los resultados, pero sí obliga a tratarlos como una observación preliminar y no como una conclusión definitiva. Los autores afirmaron que el fenómeno aparece en DeepSeek-V4 y V4.1, así como en todos los modelos comprimidos que preentrenaron.
La investigación plantea así una tensión entre eficiencia y precisión: ahorrar recursos no garantiza que todas las respuestas conserven el mismo nivel de exactitud. Sin datos adicionales, no es posible determinar el alcance práctico del problema en el uso cotidiano.