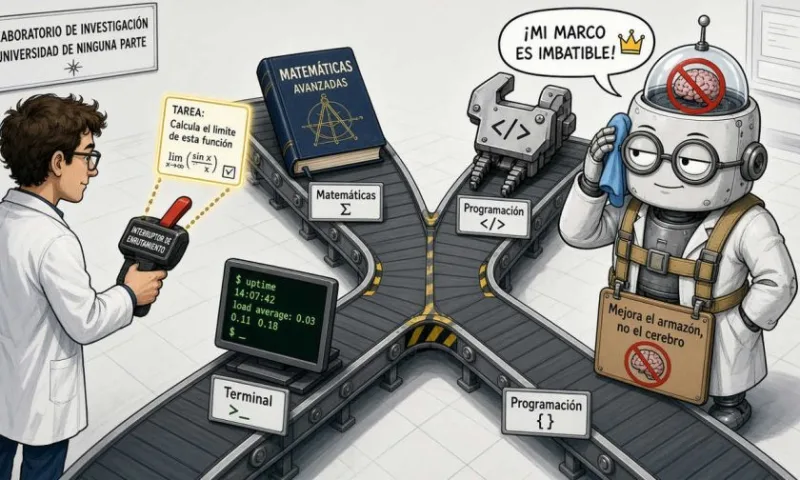
Investigadores de Meta, la Universidad de Duke y la Universidad de California, Davis, propusieron una forma de mejorar agentes de inteligencia artificial sin volver a entrenar el modelo que los impulsa. El sistema organiza la optimización del entorno del agente en ramas especializadas y, cuando llega una tarea, un enrutador elige la que mejor se ajusta.
En una prueba de razonamiento matemático de nivel olímpico con Gemini 3 Flash, el método elevó la precisión de 46,0% a 62,0%, según los autores. También reportó mejoras en Terminal-Bench 2.0 y SWE-bench Lite frente a Meta-Harness.
El entorno también cambia el desempeño
Un modelo de lenguaje no trabaja solo cuando forma parte de un agente. A su alrededor hay instrucciones, herramientas, contexto y reglas que determinan cómo ejecuta sus acciones; ese marco de código es lo que el estudio denomina un armazón del agente.
Ese entorno influye en la forma en que el modelo interpreta una solicitud y en los recursos que puede emplear para responderla. Las herramientas habilitadas y el contexto que recibe forman parte de ese sistema operativo, aunque no cambien el conocimiento incorporado en los parámetros del modelo durante su entrenamiento.
Optimizar un armazón significa buscar automáticamente una configuración que ayude al agente a resolver mejor las tareas previstas. Los autores plantean que una sola ruta de búsqueda puede dejar mejoras sin explorar, porque una estrategia útil para matemáticas no necesariamente funciona igual de bien en una terminal o en ingeniería de software.
El trabajo desarrolla una propuesta anterior, Meta-Harness, y reemplaza una búsqueda única por varias ramas con trayectorias especializadas.
Ramas especializadas y selección por tarea
Cada rama evoluciona por separado y trabaja con un subconjunto distinto de datos de desarrollo. Además, cada una usa su propia política para proponer cambios en el armazón, de modo que la búsqueda no depende de una sola estrategia.
Las ramas también usan su historial para orientar sus siguientes intentos. Cada una conserva los casos en que supera a las demás y ajusta su enfoque a partir de los resultados anteriores.
Un enrutador decide qué rama se usa cuando llega una tarea durante el despliegue. En lugar de aplicar una sola configuración a todas las entradas, el sistema selecciona la cabeza de rama que considera más adecuada para cada caso.
Los investigadores afirman que la optimización se realiza con datos del conjunto de desarrollo y que las ramas no acceden al conjunto de prueba durante ese proceso.
Resultados en matemáticas, terminal y programación
El resultado más destacado corresponde al razonamiento matemático de nivel olímpico. Con Gemini 3 Flash, la precisión pasó de 46,0% a 62,0%, y los autores describen ese salto como una mejora relativa de 34,8%.
En Terminal-Bench 2.0, que evalúa agentes que trabajan en una terminal, el sistema obtuvo una ganancia de 11,6%, según el artículo. SWE-bench Lite, una prueba de ingeniería de software, mostró un aumento de 3,8%.
Los autores sostienen que los resultados se obtuvieron sin reentrenar Gemini 3 Flash ni modificar sus pesos. La contribución que buscan mostrar es que el rendimiento puede cambiar al optimizar las instrucciones, herramientas, contexto y ejecución que rodean al modelo.
El trabajo, titulado Mixture of Self-Improving Branches for Agent Harness Optimization, circula como preprint y todavía no equivale a conclusiones validadas mediante revisión formal por pares. Entre sus autores figuran Haoyu Dong, afiliado a Meta y Duke, y Zihao Lin, afiliado a Meta y UC Davis.
La propuesta también deja abierta una cuestión práctica: mantener varias estrategias evolutivas y un enrutador puede sumar complejidad al sistema. El material disponible no cuantifica ese costo operativo.
Para una muestra visual del anuncio, la publicación compartida por DiarioBitcoin puede verse en este mensaje en X.