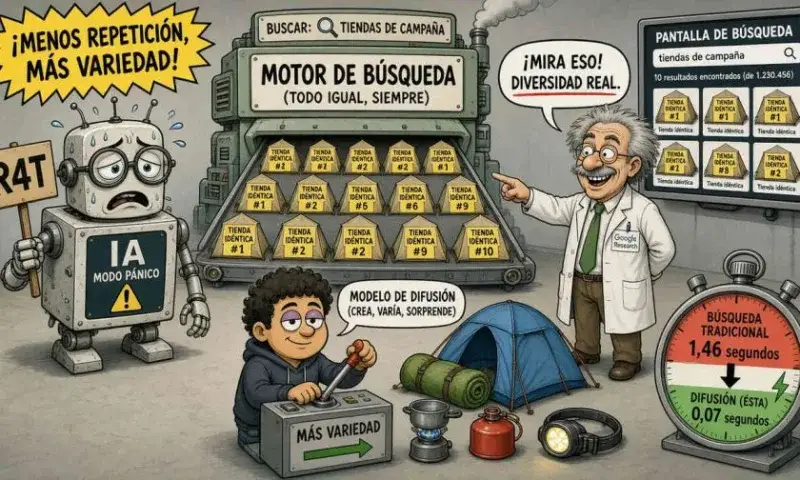
Google Research presentó Retrieve-for-Train, conocido como R4T, un marco diseñado para optimizar la forma en que los sistemas de búsqueda expanden una consulta amplia. En lugar de devolver resultados casi idénticos, la herramienta produce varias rutas de recuperación orientadas a cubrir elementos complementarios de manera simultánea.
La propuesta aborda dos problemas recurrentes en las técnicas de expansión de consultas: el colapso parafrástico, donde los modelos generan expresiones casi sinónimas, y el elevado costo temporal de la generación autorregresiva. Para superar estos obstáculos, R4T separa el aprendizaje de la política de fan-out y su ejecución posterior mediante una destilación en un modelo compacto.
Funcionamiento y recompensas del sistema
El proceso utiliza un modelo de lenguaje de fan-out para generar múltiples subconsultas evaluadas mediante una recompensa a nivel de conjunto. Esta métrica combina la fundamentación para penalizar la distancia con los elementos de la base de datos, la diversidad a través del Vendi Score y la alineación con la instrucción original.
Las pruebas realizadas en conjuntos de datos como Polyvore y colecciones musicales demostraron que la arquitectura no solo preserva la relevancia, sino que amplía de manera notable la variedad de los resultados obtenidos durante los experimentos informados por la publicación oficial en la red social.
Rendimiento y tiempos de ejecución
La ventaja más evidente del nuevo marco se refleja en las mediciones de velocidad. Mientras que los métodos tradicionales registran tiempos elevados al procesar lotes grandes de consultas, el modelo de difusión integrado en R4T reduce la latencia de forma drástica para la infraestructura a gran escala.
Con estos avances, la investigación de Google abre una vía para trasladar el aprendizaje por refuerzo hacia los sistemas de recuperación de información sin asumir el costo computacional completo de una política autorregresiva durante la fase de inferencia.